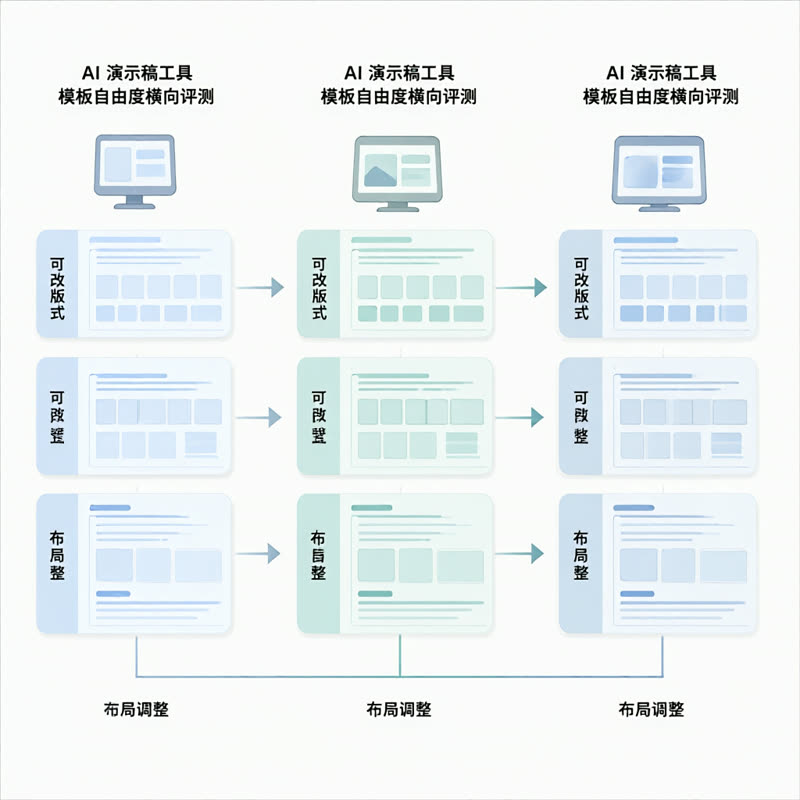
AI 演示稿工具模板自由度横向评测:从可改版式到品牌系统
本文横向评测主流 AI 演示稿工具在模板自由度上的差异,从版式可塑性、品牌系统、组件粒度、导出协作等维度展开,并给出不同团队与场景下的选择建议。
ChatGPT vs Claude、Midjourney vs DALL-E……硬核AI工具对比评测,一篇文章看懂该选哪个。
本文横向评测主流 AI 演示稿工具在模板自由度上的差异,从版式可塑性、品牌系统、组件粒度、导出协作等维度展开,并给出不同团队与场景下的选择建议。
本文从隐私敏感场景出发,对比本地模型与云端模型的直接成本、合规成本、运维成本与隐性成本,并给出不同规模团队的选型建议与可执行落地路径。
从韵律停顿、字音准确、长程稳定性、情绪表现与合规成本五个维度,横向对比云厂商、开源模型、海外平台与成品配音工具在中文长文本上的自然度表现,并给出分场景选型与可落地的试用建议。
从提示语义、结构控制、风格一致性、产品与角色还原、局部返修和合规成本等维度,对比 Midjourney 与 FLUX 在商业出图上的可控性,并给出场景选择与混合工作流建议。
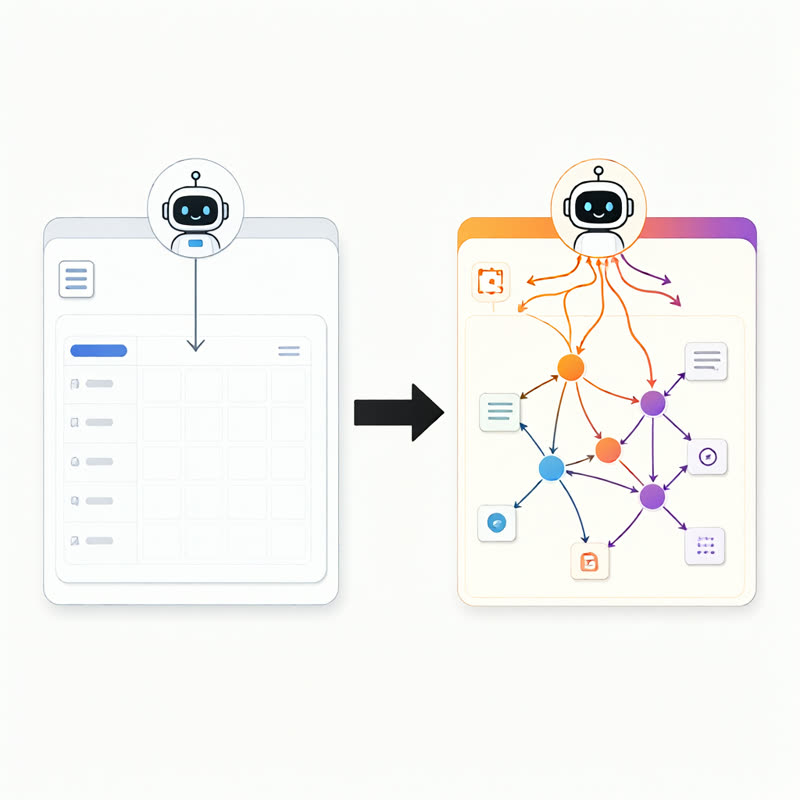
从入口、知识检索、会议纪要、文档协作、权限治理与部署成本六个维度,对比 Notion AI 与飞书智能助手在团队协作中的落地差异,并给出按场景选型与试点建议。
从编排模型、节点生态、状态管理、调试治理与部署边界五个维度,对比 n8n 与 Dify 的自动化编排适用边界,并给出场景推荐、混合架构与可执行选型建议。
从角色、场景、镜头、风格与叙事五个维度,横向比较 Runway 与可灵在短视频生成中的一致性表现,并给出不同创作场景的选择建议与可执行测试方法。
围绕 Perplexity 与 Gemini 在事实核查中的引用质量,从可追溯性、来源权威、时效、论断对齐、冲突处理与中文覆盖等维度横向对比,并给出场景推荐与可执行核查清单。
从结构保持、事实保真、术语一致与多轮修订等维度,对比 Claude 与 ChatGPT 的长文档改写稳定性,并给出合同、技术文档、学术与营销场景的选型建议。
从上下文检索、跨文件约束、长文件续写、重构后适应等维度,对比 Cursor 与 Windsurf 在大型仓库中的补全准确度,并给出团队选型与落地建议。