👁 122 次阅读
2026年10月19日,微软在官方开源博客上宣布了一个新产品:Scope。它不是又一个 AI 编码智能体,而是一台给编码智能体出题、监考、阅卷的机器——用微软自己的话说,是『开源的智能体体验评测平台』。MIT 协议、Kubernetes 原生、由微软开发者关系团队(Developer Relations)打磨了一年多才拿出来。就在同一天,GitHub 从 Copilot 里下架了六个模型。这两件事放在一起看,才是 Scope 真正想解决的问题:当编码智能体的底座一个月换三轮,你的团队靠什么知道手里的 agent 到底还行不行?
本文基于微软官方发布博客、GitHub 仓库、官方文档以及多家第三方报道整理。先交代 Scope 是什么、怎么打分,再把它最值得警惕的三个真相摊开:官网演示一个 agent 都没跑、免费开源背后的部署成本、以及阅卷官自己也是个会犯错的 LLM。结论放在最后——它适合谁,不适合谁。
一、Scope 是什么:考场,不是考生
Scope 官方文档里有一句话定义:『一个衡量你的产品在各 AI 编码智能体上的智能体化编码体验的平台——提交把任务提示词、评测标准(criteria)和配置档案(profile)配对的 request,然后检查每次 run 的结构化通过/失败报告。』
拆开看就是三层:你出题(任务提示词+成功标准+agent 配置),Scope 驱动真实 agent 去执行,然后把执行过程变成可检查的证据。它自己不写一行代码,所以它不是考生的竞争者,而是考场本身。
入口有三个:网页 Portal、scope CLI、REST API(同一域名下的 /api/v1)。CLI 的安装是一行命令 curl install-cli.sh,但真正用起来需要连到某个已部署的实例。
它今天能驱动哪些 agent?官方支持矩阵写得很清楚:GitHub Copilot、Anthropic 的 Claude Code、以及 VS Code 配 Copilot 的组合,今天就能跑;OpenAI Codex 和开源的 OpenCode 在计划中;Cursor 明确标注『未集成』。注意一个细节:官方 FAQ 里写明,ACP 协议的 worker 会直接拒绝安装 VS Code 扩展(HTTP 400)——这意味着给 agent 加扩展这条路,在某些 worker 上是堵死的。
配置用『版本化档案』(profile)固化:worker、模型、agent 版本、skills、MCP 服务器、扩展,全部记录在案。你还可以设置不同的 persona,模拟不同视角和沟通风格的『虚拟用户』。改一个变量、重跑同一道题、对比结果——这就是 Scope 的核心工作流。
Scope 核心概念速览
| 概念 | 含义 |
|---|---|
| request | 你提交的东西,由任务提示词、评测标准、配置档案三件套组成 |
| run | 一次执行尝试;第一次自动创建,每次重试追加一次 run,日志和报告按 run 分开 |
| profile | 版本化 agent 配置,记录 worker、模型、agent 版本、skills、MCP、扩展 |
| criteria | 评测标准,组织成有向无环图,检查之间可以互相依赖 |
| Judge | LLM 阅卷服务,对照 criteria 给每次 run 打分 |
| 证据 | 日志、生成文件、工作区快照、工具调用轨迹,全部保留供复查 |
二、怎么给 agent 打分:依赖图 + LLM 阅卷官
Scope 最值得称道的设计,是把『成功』拆成一张依赖图,而不是一个简单的 pass/fail。官方把它建模为有向无环图(DAG):一项检查可以独立存在,也可以依赖前置检查——比如『运行时检查』必须等『构建成功』过了才轮到它。官网的示例任务是一座任务看板(task board):用户可以添加任务、标记完成、按状态筛选,空标题不能创建任务。对应的三道闸门依次是:Requirements gate(任务实现)、Build gate(构建成功)、Test gate(测试执行→测试通过→空输入处理)。注意 Test gate 内部还有依赖:『测试执行』失败的话,『测试通过』和『空输入处理』两个检查会被直接跳过,而不是继续往下走——这种门控逻辑比平铺的打分表更能反映真实工程里『一步错步步错』的结构。
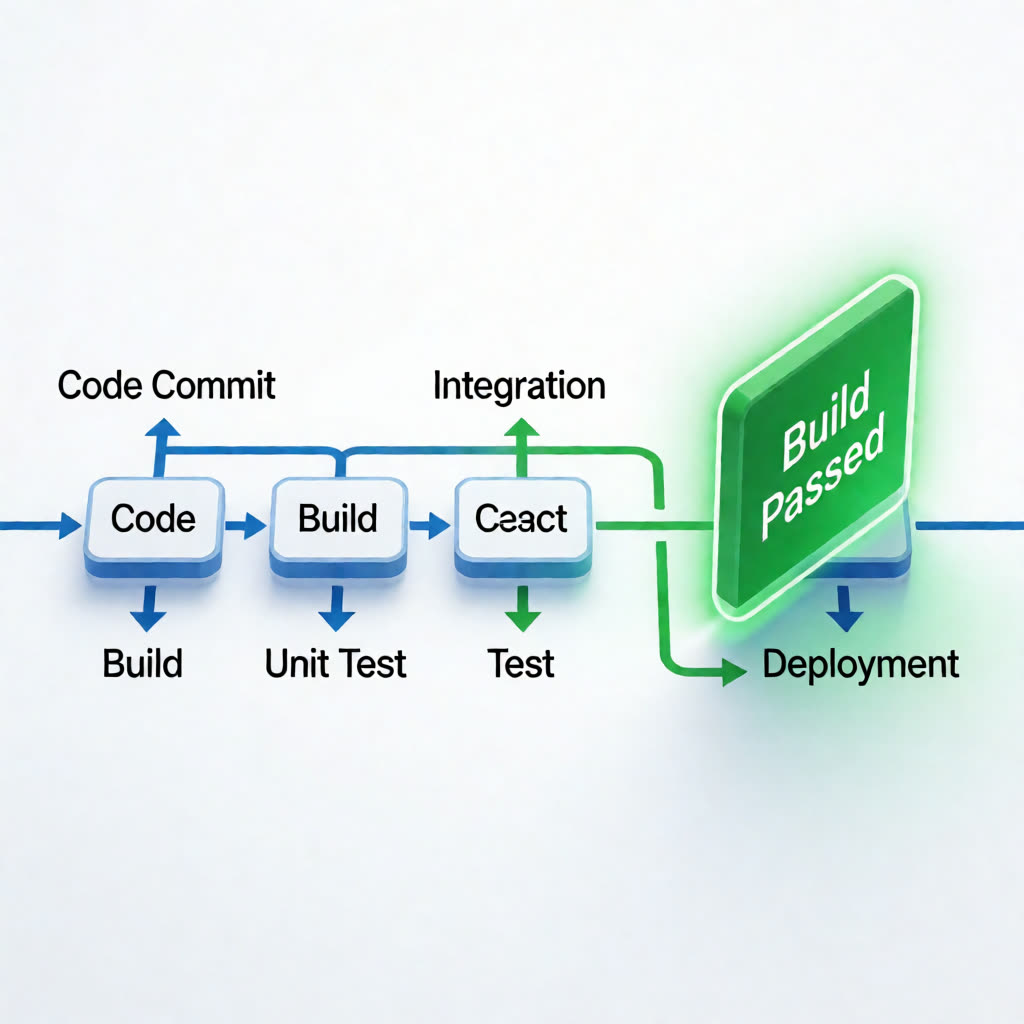
打分由 Judge 服务完成:一个基于大语言模型的阅卷程序,对照 criteria 逐项评估输出。每次 run 会保留完整证据链——实时日志、生成的文件、工作区快照、工具调用轨迹——让你能把一个失败的检查一路追回到具体是哪一步出了岔子。
这套方法论不是 Scope 发布当天才有的。10月6日微软开发者博客先定义了『智能体体验』(Agent Experience,AX):智能体在发现、选择、使用你的 SDK、API、CLI、文档和 MCP 服务器时的体验,用两个指标衡量——倾向性(propensity,智能体会不会选你的技术)和有效性(efficacy,选了之后能不能用对、会不会踩废弃接口)。10月9日又发布了 AX Practitioner Playbook,把评测落地成一步步的方法。Scope 就是这套方法论的开源执行平台。
三、真相一:官网演示从头到尾没有一个 agent 在跑
打开 Scope 官网首页,你会看到一个很精致的交互演示:一道任务看板题,三种配置(基线、加 skill、换 agent),三道闸门,还有 token 数和耗时。但它上面有一行字,英文原文是:No agents run here. All results are pre-written examples. All outcomes, token counts, and durations are invented, not measured benchmarks or agent rankings.
翻译过来就是:这里没有 agent 在跑,所有结果都是预先写好的示例,所有 token 数、耗时都是编的,不是实测的基准,更不是 agent 排名。演示里出现的 Codex 和 OpenCode 也只是『计划中』的占位——今天根本不可用。
这不是什么隐藏缺陷——微软把免责声明写得比谁都直白,值得表扬;但它揭示了一个现实:2026 年 10 月的 Scope 还处在『给你看效果图』的阶段,而不是『打开就能看到真实评测』的阶段。想看到它真的在评测,你得自己部署一套。这引出了第二个真相。
四、真相二:『免费开源』是真的,但跑起来要六件套加两个付费前置
Scope 的软件本身确实免费:MIT 协议,GitHub 仓库 microsoft/scope,无授权费,也没有任何托管服务的价格——因为它根本没有托管版。它是『你自己部署的软件』,不是订阅服务。
但本地跑起来的第一步就劝退:官方文档列出的前置包括 Docker(要 Compose v2)、Node 22、pnpm、mkcert、GitHub CLI。这还只是环境。真正的前置成本有两个:默认 worker 需要一个『活跃的 GitHub Copilot 权益』,也就是你或你的组织得有 Copilot 订阅;Judge 服务需要模型提供商的凭据——你想让哪个模型当阅卷官,就得给哪个模型付费。
于是成本就变成了一张隐藏账单:每一次评测 run 都在消耗 Copilot 的 AI 额度,超出套餐的部分按 0.01 美元每 credit 计费;Judge 每次打分还要烧模型 token。GitHub Copilot 当前各档位如下(来源:GitHub Copilot 定价页,经 TrendinTech 2026 年 10 月整理):
| 档位 | 价格 | 每月 AI 额度 |
|---|---|---|
| Free | 0 美元 | 2000 次代码补全 + 50 次聊天 |
| Pro | 10 美元/月 | 1000 AI credits |
| Pro+ | 39 美元/月 | 3900 credits + 高级模型权限 |
| Business | 19 美元/席位/月 | 每用户 1900 credits |
| Enterprise | 39 美元/席位/月 | 每用户 3900 credits + 优先高级模型 |
| Max | 100 美元/月 | 10000 credits + 优先高级模型 |
一家团队每天跑几百次评测、横跨多个 agent,这条账单就是实打实的运营开支。更不用说如果走共享部署,官方推荐的是 Kubernetes + Helm,配 KEDA 按队列深度自动扩缩 worker,用 Flux 做 GitOps 交付——这套组合拳明摆着是给『组织级持续评测』设计的,不是给个人开发者玩票的。也就是说:软件免费,考场很贵。
五、真相三:阅卷官自己也是个 LLM,它也会犯错
Scope 的 Judge 服务用 LLM 给 agent 打分,但微软在自己的发布博客里就承认:automated judges can make mistakes(自动化阅卷官会犯错),并且明确建议,在做重要决策前,仍然需要人工复核证据。这是整篇发布文章里最诚实的一句话——一个用来衡量 agent 可靠性的工具,它的可靠性上限取决于阅卷 LLM 的可靠性。
更根本的结构局限是:你只能测你想到的场景。Scope 的 criteria 依赖图由团队自己定义,它『无法捕获没人想到要去测试的失败模式』——如果一道题的设计漏掉了某个环节,Scope 不会替你发现。它适合当『回归测试系统』,不适合当『智能体质检机器』。
还有第三层:Scope 目前是 research preview,没有编号版本,官方明说会有破坏性变更。在一个连版本号都没有的工具上搭生产流程,得做好随时被 API 变更打脸的准备。三个真相放在一起看:
| 真相 | 证据 | 影响 |
|---|---|---|
| 官网演示没跑 | 首页免责声明:结果均为预写示例,token 与耗时均为虚构 | 看演示不等于看评测,想验证必须自建部署 |
| 免费但部署重 | 六件套前置 + Copilot 权益 + Judge 凭据;生产走 K8s + KEDA + Flux | 个人玩票成本高,组织级才划算 |
| 阅卷官会犯错 | 官方博客承认 automated judges can make mistakes;依赖图只测想得到的场景 | 重大结论需人工复核,别当质检机器 |
六、真实战绩:Cosmos DB 团队已经用它改产品
如果说前面都是纸上谈兵,微软博客里引用的 Azure Cosmos DB 团队案例就是 Scope 最硬的效果证明。Jay Gordon(Azure Cosmos DB 高级项目经理)的原话是:团队用 Scope 把『裸模型』和自家 Agent Kit 放在 8 个端到端场景、5 种语言里对比,评测结果直接转化成了 20 个 Agent Kit 问题和 27 个文档问题的修复。最惊艳的一个数字:一次针对性的 Agent Kit 更新之后,分层分区键(hierarchical partition key)的采纳率从 47% 升到 100%,而 OFFSET/LIMIT 的误用从 47% 降到 0%。
这个故事的价值在于:Scope 产出的是『证据』,而证据直接指向文档哪一页该改、SDK 哪个接口该修。这正是 DevAx 闭环的完整示范——出题、评测、看证据、改产品、再出题。Cosmos DB 团队是微软自家团队,数字也是自家博客发布的,需要谨慎看待;但 47% 到 100% 这种量级的变化,指向的方向是明确的:对维护 SDK、CLI、文档、MCP 服务器的团队来说,Scope 解决的是一个真实存在的痛点——智能体用错你的产品时,往往没人察觉,直到工单找上门。
七、为什么是现在:模型轮换快得没有评测就跟不上
Scope 的发布时机几乎是为当下的模型生态量身定做的。就在 10 月 19 日 Scope 开源的同一天,GitHub 宣布从 Copilot 的大部分面(聊天、内联编辑、ask/agent 模式、代码补全)下架六个模型:Gemini 3.7 Flash、GPT-5.5、GPT-5.4、GPT-5.4 mini、GPT-5 mini 和 Grok 4.5。而过去三周里,Copilot 刚陆续换上 Gemini 4 Argon(10月13日 GA,主打复杂编码与 agentic 任务)、Claude Haiku 5.5(10月7日 GA)和 GPT-6.1 Sol(9月29日,主打 agentic 编码与终端工作流)。10 月 15 日 GitHub 又预告:Claude Opus 4.8、Claude Opus 5 和 GPT-5.6 Terra 将在 11 月 16 日弃用。
这意味着什么?一个把工作流标准化在某个模型组合上的团队,大概只有一个月的时间窗口来应对底座变更。模型换掉之后,以前能跑通的 agent 工作流可能悄无声息地坏掉——没有一套固定标准的回归评测,组织根本没有系统性的办法知道『换模型是否静默破坏了我的工作流』。Scope 想填的正是这个洞。
数据也支持这个紧迫性。Stack Overflow 2025 开发者调查显示:31% 的开发者已经在使用 AI 智能体,17% 计划使用,38% 明确不打算用;每天使用的人群占 14.1%,其中 69% 的智能体使用者认为智能体提升了他们的生产力。JetBrains 2025 生态系统报告则显示 85% 的开发者定期使用 AI 工具、62% 至少依赖一个 AI 编码助手或智能体。采纳是真的,警惕也是真的。更微妙的是 METR 2026 年的一项研究(经 TrendinTech 报道):在某些任务上,使用 AI 编码智能体的开发者反而比不用的人更慢——如果速度和『看起来能干』不能可靠地转化为『正确交付』,团队就需要一套能测量这个差距的机制。
另外留意一个时间线细节:Scope 开源后的第三天(10月22-23日),微软研究院与卡内基梅隆大学 AIMSEC 在纽约召集了 120 位学术界、产业界、政府人士,专门讨论 AI 智能体评测与治理的标准。Scope 不是孤立的产品发布,它是微软把『智能体评测』抬升成一门工程学科的动作之一。
八、适合谁,不适合谁
把真相和战绩放在一起,Scope 的适用边界其实很清楚。
适合你,如果:你在维护 SDK、CLI、文档或 MCP 服务器,想知道编码智能体到底会不会用你的东西——Scope 会告诉你智能体卡在哪一步,然后你把文档改一版、重跑一遍,看失败率是否下降;或者你所在的组织已经有 Copilot Business/Enterprise 席位,愿意把『智能体回归评测』当成 CI 一样的东西持续跑。
不适合你,如果:你只是个人开发者,想找个工具『看看哪个 agent 最强』——先算算 Copilot 额度和 Judge token 的账单再决定;或者你想拿它当代码审查的替代品——它只能测你定义好的场景,测不出你没想过的问题,该有的人工审查一步都不能省。
一句话决策建议:把它当成『自建的可复现智能体评测回归系统』来用,而不是当成『智能体排行榜生成器』。前者是 Scope 真正擅长的事,后者是它明确不承诺的事。
结论
Scope 是 2026 年 10 月最值得关注的开发者工具之一,不是因为它是又一个更强的编码智能体,而是因为它是第一台把『评测编码智能体』变成开源基础设施的机器:MIT 协议、证据留痕、标准依赖图、LLM 阅卷官,再加上一个用真实战绩说话的 Cosmos DB 案例。
但把它搬进生产之前,请记住三个真相:官网那个精致的演示,从头到尾没有一个 agent 在跑;软件免费,考场很贵,账单藏在 Copilot 额度和 Judge token 里;阅卷官自己也是个会犯错的 LLM,重大结论必须人工复核。Scope 最难得的地方恰恰是它把这些局限写在明面上——这种诚实,在 2026 年的 AI 工具里并不多见。
对维护 SDK 和文档的团队,我的建议是现在就搭一套:出一道你最关心的题,跑十次,看证据。对其他人,把这份评测存着,等 1.0 再说。
参考来源
微软官方发布博客(2026-10-19):https://opensource.microsoft.com/blog/2026/10/19/introducing-scope-open-source-evaluation-for-ai-coding-agents/
GitHub 仓库:https://github.com/microsoft/scope
Scope 官方文档:https://microsoft.github.io/scope/
TrendinTech 报道(2026-10):https://trendintech.com/microsoft-scope-open-source-ai-coding-agent-testing-2026/
It’s FOSS 报道(2026-10-20):https://itsfoss.com/news/microsoft-scope-self-hosted-agent-testing/
GitHub Copilot 定价页:https://github.com/features/copilot/plans
Stack Overflow 2025 开发者调查:https://survey.stackoverflow.co/2025/
JetBrains 2025 State of Developer Ecosystem:https://blog.jetbrains.com/research/
Pingback: Sora 停服一个月后 Veo 3.1 预览版也关停:Runway Gen-4.5 与 Kling 3.0 每秒单价深度对比 - AI百事知