👁 61 次阅读
配图
为什么长任务中断恢复是 Agent 的分水岭
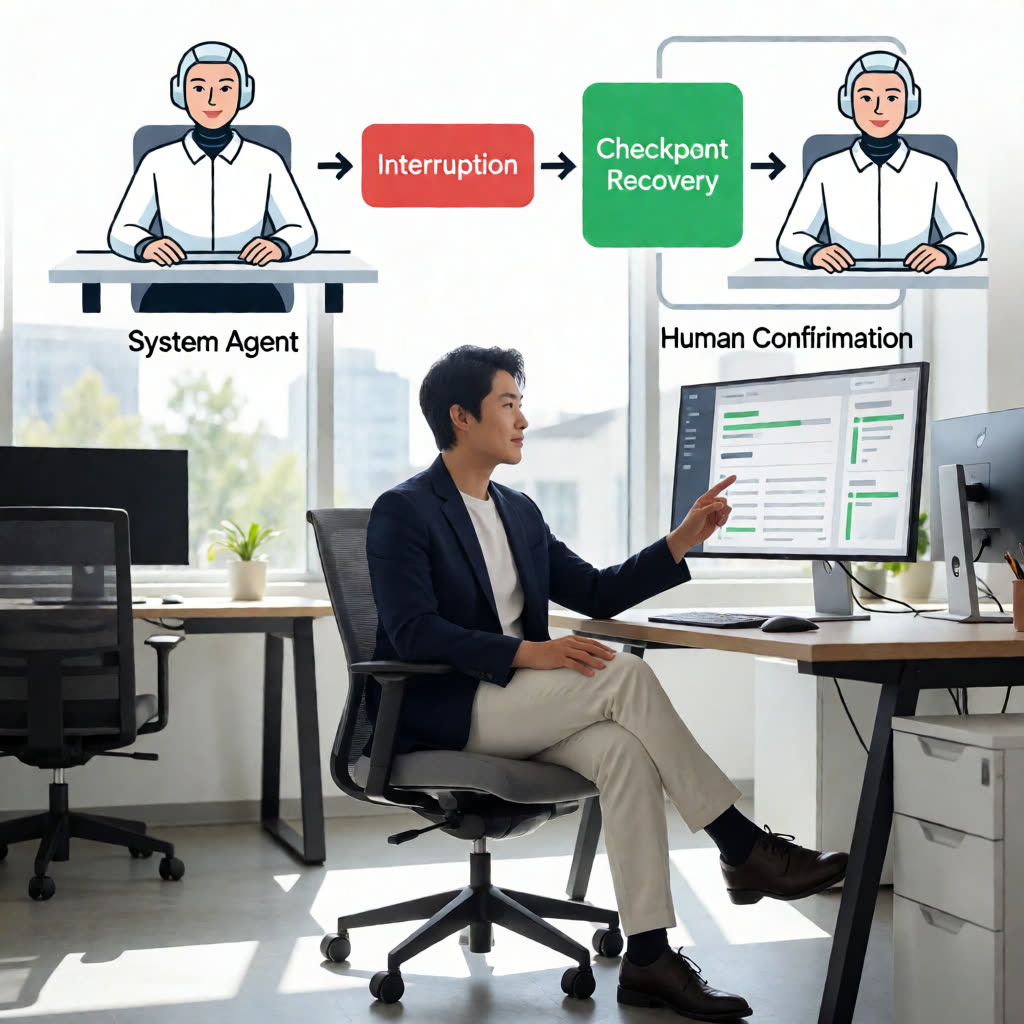
短任务看生成质量,长任务看中断之后还能不能继续。Agent 一旦跨过几分钟、几十个工具调用、多个文件和外部系统,网络抖动、限流、模型超时、页面刷新、权限过期、人工暂停都会出现。没有恢复能力,所谓自动化就退化成一次次重跑。更麻烦的是,重跑会重复产生副作用:重复发邮件、重复写库、重复下单、重复创建工单。因此,长任务中断恢复不是简单的「继续对话」,而是任务状态、工具副作用、上下文和权限的综合治理。对工具站读者而言,选 Agent 产品时只看演示顺不顺,很容易忽略真正的分水岭:断点之后,它知道自己在哪、做过什么、下一步该做什么,以及哪些动作绝不能再来一次。
配图
评测范围与方法:不看演示,看断点之后
本文对比通用助手型 Agent、办公助手、编码 Agent、浏览器操作型 Agent、工作流平台、开源编排框架和 RPA 混合方案。方法不是跑分,而是按公开文档、产品形态和用户普遍反馈做定性拆解。重点观察五件事:任务中断后能否定位断点;恢复时是否重建了足够上下文;外部副作用是否可防重;人工能否接管并修正计划;失败与恢复过程是否可审计。需要说明的是,同一产品不同版本、不同插件、不同企业配置差异很大,本文给出的是能力倾向,不是绝对结论。另一个判断标准是恢复成本:恢复时是否必须重放大段上下文,是否要重新安装依赖,是否会重复调用收费工具。恢复能力越强,越能把中断变成一次普通的状态切换,而不是一次重新开工。
八个关键维度拆解
评估 Agent 的长任务恢复能力,至少要看八个维度。
- 状态持久化:会话历史、任务计划、中间工件、工具调用结果是否落盘,落盘位置是否可迁移。
- 断点粒度:只能从轮次恢复,还是能到步骤、工具调用、事务级恢复。
- 恢复确认:恢复前是否核对已完成动作,是否要求人工确认高风险步骤。
- 外部副作用治理:发邮件、写数据库、提交表单、下单等动作是否有幂等键、审批和补偿。
- 上下文重建:恢复后能否通过摘要、检索、工件引用找回必要信息,而不是把全部历史塞回模型。
- 人工接管:能否暂停、编辑计划、替换工具、跳过步骤并保留审计记录。
- 可观测性:步骤日志、工具入参出参、失败原因、恢复点是否清晰可见。
- 权限与安全:恢复后凭据是否过期,权限是否变化,沙箱是否仍然隔离。
这八个维度里,最容易被演示掩盖的是外部副作用治理。很多产品能把对话恢复出来,却无法判断某封邮件是否已经发出,结果恢复后再次执行。真正可用的长任务恢复,必须把「做过什么」与「还能不能重做」分开管理。
状态持久化:会话、任务、工件三层
会话级保存只解决聊天记录,任务级保存计划与步骤,工件级保存文件、表格、代码、浏览器快照和数据库变更。三层都具备,恢复才稳。只有会话级的产品,适合问答和短流程;任务级决定它能否做多步骤自动化;工件级决定它能否在编码、数据处理和浏览器操作里接上断点。企业选型时,应该追问状态存在哪里、能否导出、能否跨设备继续、是否受租户权限控制。
断点粒度:越细越贵,越粗越省
断点粒度越细,恢复越精确,但实现成本越高。轮次级恢复成本低,适合写作与资料整理;步骤级恢复要求每个计划节点都有状态;工具调用级恢复要求记录入参、出参和幂等键;事务级恢复则要处理外部系统的一致性。多数产品在步骤级和工具调用级之间取舍。对高风险业务,粒度不是越细越好,而是要与副作用等级匹配:只读任务可以粗,写操作必须细。
外部副作用:恢复能力真正的暗礁
读网页失败可以重试,写数据库失败不能盲目重放。Agent 恢复时必须区分可重放动作与不可重放动作。常见做法包括幂等键、发件箱模式、人工审批、补偿事务和沙箱预演。产品如果只提供「继续」按钮,却不展示已完成动作清单,就不适合直接接入生产系统。用户普遍反映,真正让人不敢放手的不是模型会不会犯错,而是中断后不知道它到底做没做。
人工接管与可观测性:能不能看懂为什么断
好的恢复体验不是全自动,而是该自动时自动、该停时停。可观测性包括步骤时间线、工具调用详情、错误分类、恢复建议和变更对比。人工接管则要求能编辑计划、替换失败工具、跳过非关键步骤,并把修正写回任务状态。没有这些,恢复就变成盲盒:用户只能选择重跑或放弃。
主流产品横向对比表
下表按产品形态做定性对比。表中的「较强」「中等」「有限」是相对判断,不代表具体版本在所有配置下的表现。
| 产品/类别 | 状态保存 | 断点粒度 | 外部副作用控制 | 人工接管 | 恢复体验判断 |
|---|---|---|---|---|---|
| 通用助手型 Agent,如 ChatGPT、Claude、Gemini 等 | 会话与文档级较强 | 轮次到步骤级 | 依赖工具确认与用户把关 | 支持暂停与确认,产品差异大 | 适合研究写作,长流程工具任务需人工兜底 |
| 办公助手型,如 Microsoft 365 Copilot、Google Workspace 助手等 | 宿主文档自动保存 | 文档操作级 | 受权限与审批约束 | 可在应用内接管 | 单应用内较稳,跨应用长流程偏弱 |
| 编码 Agent,如 Cursor、Claude Code、GitHub Copilot、Devin 等 | 仓库、计划文件与终端日志可承载 | 步骤与命令级 | 靠分支、沙箱、回滚与测试 | 支持差异审阅与终端接管 | 恢复刚需最强,环境漂移是难点 |
| 浏览器操作型 Agent | 页面快照与登录态 | 动作级偏弱 | 高风险动作需确认 | 人工接管直观 | 易受页面变化影响,需快照与重放保护 |
| 工作流平台,如扣子、Dify、n8n、Zapier 等 | 节点级持久化 | 节点与重试级 | 重试、审批、补偿可配置 | 审批节点较成熟 | 结构化流程稳,开放式推理弱 |
| 开源编排框架,如 LangGraph、AutoGen、CrewAI 等 | 取决于检查点与存储实现 | 可实现步骤级 | 需自建幂等与补偿 | 需自建接管界面 | 上限高,工程成本高 |
| 多 Agent 协作框架 | 角色状态与消息队列 | 消息级 | 需协调事务与仲裁 | 需人工仲裁入口 | 适合复杂任务,恢复设计难 |
| RPA 加 Agent 混合方案 | 流程引擎加截图日志 | 事务与节点级 | 审批与回滚较成熟 | 控制台接管 | 稳定性较好,灵活性有限 |
从表格可以看出,恢复能力强的产品未必最聪明,但通常更重视状态与副作用。编码 Agent 和工作流平台因为天生有仓库、节点、日志等结构,恢复设计更容易落地;浏览器 Agent 因为页面状态易失,反而最需要快照与人工确认;通用助手体验自然,但长流程边界最模糊。
通用助手型 Agent:恢复体验最自然,边界也最模糊
通用助手型产品的优势是交互自然,用户可以随时补充信息、纠正方向。中断后,会话历史和文档工件通常还在,继续对话的体验比较顺。但这类产品的问题也明显:任务计划往往藏在上下文里,工具调用结果不一定完整落盘,恢复后模型可能根据摘要重新推断,而不是读取精确状态。对于资料整理、写作、分析类任务,这种恢复方式够用;对于跨系统写操作,必须要求产品展示已完成动作清单,并允许人工确认。选型时不要只看它能否「记住」,要看它能否说清楚「上次做到哪一步、哪些动作已经产生外部影响」。
编码型 Agent:断点恢复最刚需,仓库状态是难点
编码任务天然适合恢复:代码在仓库里,变更可以用差异表达,测试可以重跑,计划可以写成文件。编码 Agent 如果能把任务拆成可验证步骤,并借助分支、提交、测试日志和沙箱快照保存状态,中断恢复会明显好于纯对话产品。难点在于环境漂移:依赖版本、密钥、数据库、后台进程、临时文件都可能导致恢复后跑不通。另一个难点是未提交变更与人工修改的冲突。企业落地时,应把「恢复前先跑测试」「恢复后先看差异」「高风险命令需审批」写成硬规则,而不是依赖模型自觉。
浏览器与操作型 Agent:页面一刷新,恢复难度陡增
浏览器 Agent 面对的是持续变化的外部世界。页面刷新、登录过期、验证码、弹窗、A/B 测试、DOM 变化都会让恢复点失效。它需要保存的不只是对话,还包括当前网址、页面快照、表单填写状态、已点击按钮和待确认动作。更关键的是,浏览器里的提交往往不可逆:提交表单、发送消息、确认订单都可能产生真实副作用。因此,浏览器 Agent 的恢复能力必须与人工确认绑定。适合的场景是信息收集、比价、后台录入辅助;不适合无人值守的高风险提交。选型时要重点看它是否提供动作回放、截图留痕和失败原因分类。
工作流与编排平台:恢复能力藏在节点设计里
工作流平台把任务拆成节点,天然具备节点级状态、重试和错误分支。扣子、Dify、n8n、Zapier 这类产品的恢复能力,主要取决于节点是否幂等、是否支持人工审批、是否记录每次执行输入输出、是否能从失败节点继续。它们的优势是结构化、可审计、适合企业流程;弱点是开放式推理和动态规划不如通用 Agent 灵活。实际使用中,常见做法是把长任务拆成「Agent 节点加人工审批节点加外部工具节点」,让 Agent 负责不确定部分,让工作流负责状态与副作用。这样比让一个 Agent 从头到尾自由发挥更稳。
开源框架:恢复不是开关,而是架构能力
开源编排框架的恢复能力上限很高,但需要自己设计。以 LangGraph 这类图编排思路为例,检查点、状态存储、人工中断、时间旅行调试都是可组合能力;AutoGen、CrewAI 等多 Agent 框架则更强调角色协作与消息传递。问题在于,框架只提供机制,不替你决定幂等键、补偿事务、权限边界和审计格式。团队如果要把开源方案用于生产,必须把恢复当作架构需求,而不是后期补丁。至少要有持久化存储、状态版本、工具调用日志、失败重试策略和人工接管接口。否则,演示很稳,线上中断一次就暴露问题。
场景推荐:不同任务该看什么指标
选型不应该问「哪个 Agent 最强」,而应该问「这类任务中断后最怕什么」。下面按场景给出侧重。
- 研究与写作:优先看上下文重建和文档工件保存。恢复后能接着写、引用不丢、版本可回退,比工具级恢复更重要。
- 数据分析:优先看中间表、脚本、图表工件和运行环境。恢复时要能确认数据是否已写入,避免重复跑批。
- 编码与运维:优先看仓库状态、命令日志、沙箱快照、测试结果和人工审批。恢复后先看差异,再决定是否继续。
- 浏览器操作:优先看页面快照、登录态、动作回放和高风险确认。不要给不可逆提交开放全自动恢复。
- 企业流程:优先看节点级持久化、幂等键、审批节点、补偿事务和审计导出。结构化流程比自由 Agent 更适合生产。
- 多 Agent 协作:优先看消息队列、角色状态、任务分派与仲裁机制。没有仲裁,恢复后容易重复劳动。
如果任务同时涉及读和写,建议把读写拆开:读操作可以粗粒度恢复,写操作必须细粒度确认。这个原则比单纯比较产品功能更实用。
常见误区与选型陷阱
- 把会话记忆当成任务恢复:记住聊天不等于记住任务状态,更不等于知道哪些外部动作已完成。
- 把自动重试当成恢复:没有幂等保护的重试可能放大副作用,尤其是发信、下单、写库。
- 只看成功演示:演示通常不会展示断网、限流、权限过期和人工修改后的冲突。
- 忽略恢复成本:恢复时重放大量上下文、重新安装依赖、重复调用收费工具,都会让长任务变得不经济。
- 忽略权限变化:中断期间凭据过期或权限被收回,恢复后可能继续用旧权限尝试,带来安全风险。
- 忽略人工接管:没有暂停、编辑计划、跳过步骤和审计记录,恢复就只能靠重跑。
这些误区的共同点是:把 Agent 当成一个更长的对话框,而不是一个有状态、有副作用、需要治理的执行系统。长任务越接近生产,越要按后者设计。
结论与可执行建议
横向看,长任务中断恢复能力大致呈现这样的格局:编码 Agent 和工作流平台因为结构清晰,恢复能力更容易做扎实;通用助手型产品体验自然,适合知识工作,但长流程写操作要谨慎;浏览器 Agent 恢复难度最高,必须靠快照和人工确认兜底;开源框架上限最高,但需要团队自己补齐状态、幂等、审计和接管能力。选型时,不要被「支持继续」这类单点功能打动,而要检查它能否回答三个问题:断在哪、做过什么、下一步如何安全继续。
- 先列任务清单,标出只读步骤与写操作步骤,写操作必须单独设计确认点。
- 要求产品展示步骤时间线和已完成动作清单,不能只给一个继续按钮。
- 为所有外部写操作设计幂等键或唯一业务号,恢复前先查状态再执行。
- 把长任务拆成可验证阶段,每个阶段有明确产物、验收标准和回滚方式。
- 在正式使用前做一次人为中断演练:断网、刷新、撤回权限、修改文件,观察恢复表现。
- 保留人工接管入口和审计日志,恢复后先看差异与日志,再决定是否自动继续。
如果只能先做一件事,我建议从「外部副作用清单」开始:把所有会改变外部系统的动作列出来,为每个动作定义幂等键、确认人和回滚方式。完成这一步,再谈 Agent 的断点恢复才有意义。否则,恢复得越顺,重复执行的风险可能越大。对工具站读者来说,真正值得收藏的不是某个产品的恢复按钮,而是一套能跨产品复用的恢复检查表。