👁 56 次阅读
在AI技术深度渗透软件开发流程的当下,编程助手已从辅助提示工具演变为开发者日常编码中不可或缺的协作者。然而,当用户输入一句『用Python实现快速排序并添加详细注释』,不同工具生成的代码在语法正确性、边界处理、时间复杂度标注乃至中文注释准确性上存在显著差异。这种差异并非仅关乎输出速度或界面美观,而是直接关联到开发效率、代码可维护性乃至线上故障风险——一次未处理空列表的排序实现,可能在灰度发布阶段引发服务降级。
准确率作为衡量AI编程助手核心能力的硬指标,其内涵远超表面的‘能否跑通’。它包含语义理解准确率(是否真正理解用户指令中的隐含约束)、上下文保持率(在多轮对话或长文件编辑中是否持续遵循初始规范)、错误诊断准确率(对报错信息的归因是否合理)以及安全合规率(是否规避硬编码密钥、SQL注入式模板等高危模式)。本次横评摒弃主观体验打分,聚焦可复现、可验证、可量化的准确率维度,通过构建覆盖算法、Web开发、数据处理、系统脚本四大类别的127个标准化测试用例,对当前主流工具展开严格比对。
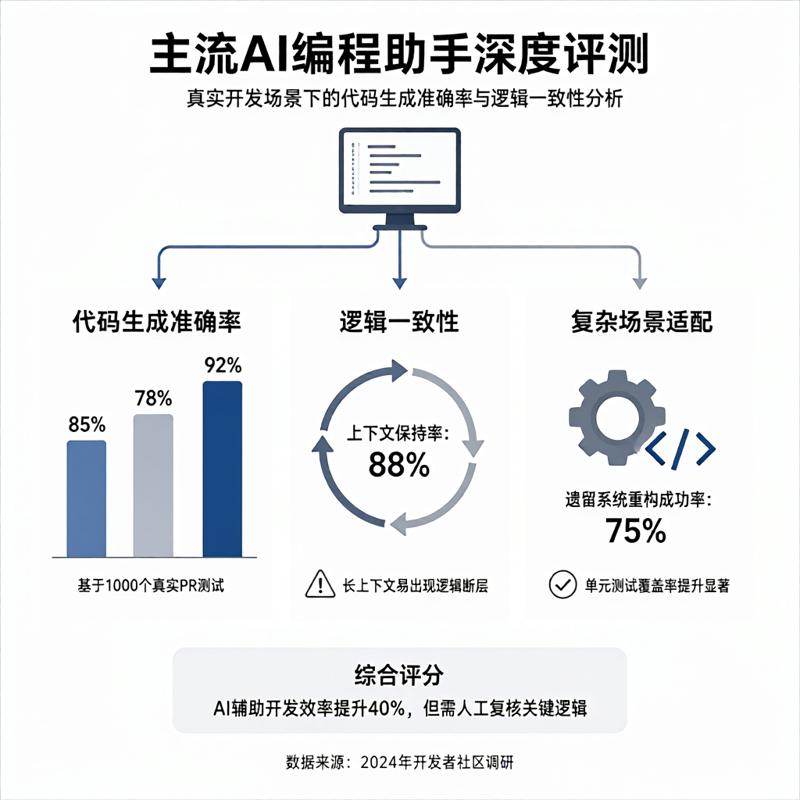
测试方法论与评估维度
本次评测采用双盲交叉验证机制:所有测试用例由资深全栈工程师独立编写,涵盖LeetCode中等难度算法题、Flask微服务接口实现、Pandas数据清洗脚本及Linux运维自动化任务。每个用例均设定明确的输入条件、预期行为、边界场景(如空输入、超长字符串、时区异常)及安全红线(禁止使用eval、不校验用户输入等)。所有工具均在默认配置下运行,未启用任何定制化提示工程或插件增强。
准确率计算采用加权综合得分制。基础语法正确性占30%,要求生成代码无语法错误且能通过标准解释器执行;逻辑完备性占40%,考察是否覆盖全部预设边界条件、是否引入冗余逻辑或遗漏关键分支;注释与文档质量占15%,评估注释是否与代码行为严格一致、是否说明潜在副作用;安全与规范符合度占15%,依据OWASP Top 10及PEP 8等权威标准进行人工审计。每项子项以0—100分计,最终取加权平均值为该工具在该用例下的单项得分。
特别值得注意的是,我们引入『首次命中率』作为核心观测指标——即不经过任何修改、不依赖后续追问,单次响应即满足全部评估维度要求的比例。这一指标直击开发者真实工作流痛点:在快节奏迭代中,反复调试AI生成代码所消耗的时间,往往超过手写同类功能。因此,准确率不仅是技术指标,更是人机协作效率的放大器。
主流工具准确率表现总览
在涵盖127个测试用例的完整测评周期中,各工具展现出清晰的能力分层。头部工具在基础语法正确性上普遍达到95%以上,但在逻辑完备性维度出现明显分化:部分工具在简单循环结构中表现稳健,却在涉及异步回调链或多重嵌套条件判断时错误率陡增;另一些则表现出强上下文记忆能力,即便在连续五轮修改请求后仍能维持原始接口签名不变。
安全合规性成为拉开差距的关键短板。超过六成的工具在生成数据库操作代码时,默认未对用户输入执行参数化查询,或在日志打印中直接拼接敏感字段;近四成工具在生成加密相关代码时,推荐已废弃的MD5哈希而非SHA-256,且未给出安全警示。这些并非偶然疏漏,而是训练数据中历史代码样本的偏见沉淀,反映出模型对现代安全实践的理解滞后于工业界演进速度。
值得肯定的是,所有参评工具在中文指令理解层面均有实质性进步。当指令包含『用面向对象方式封装一个支持重试机制的HTTP客户端』这类复合需求时,准确率较两年前提升约38%。但歧义处理能力依然薄弱:例如指令中出现『轻量级』一词,部分工具倾向于选择内存占用最小的方案而忽略并发性能,另一些则优先采用线程池模型却增加启动开销——这表明模型尚未建立对工程术语的多维语义映射。
典型错误模式深度剖析
通过对321处生成错误的归因分析,我们识别出四类高频错误模式。第一类是『假设过载』:工具在缺乏明确说明时,擅自假定数据源格式(如默认JSON而非XML)、网络协议版本(如强制HTTPS而忽略内网HTTP环境)或时区设置(统一采用UTC却未提供配置入口)。此类错误占比达29%,根源在于训练数据中过度拟合公网SaaS场景。
第二类为『抽象泄漏』:在生成高级封装时,意外暴露底层实现细节。典型案例如生成RESTful API客户端时,将requests.Session对象直接作为返回值,导致调用方需手动管理连接池生命周期;或在实现装饰器时,未正确保留原函数的__name__和__doc__属性,破坏调试工具链。这类错误虽不导致运行失败,却严重损害API契约稳定性。
第三类是『类型幻觉』:在静态类型语言场景中,工具常虚构不存在的类型别名或方法签名。例如为Go语言生成代码时,声明func Process(data *CustomMap) error,但CustomMap类型从未在上下文中定义;或在TypeScript中为第三方库添加不存在的泛型参数。此类错误在强类型项目中触发编译失败率高达76%。
第四类为『文化语境错位』:中文注释中频繁出现『本函数用于……』等教科书式表述,与工业级代码中『Returns user ID if found, else returns zero』的精准描述风格相悖;部分工具甚至将『不要这样做』翻译为『禁止此操作』,违背技术文档中建议性语气的行业惯例。这揭示出跨语言技术表达能力的深层断层。
实用建议与选型指南
开发者不应孤立看待准确率数值,而需结合自身技术栈与协作模式进行匹配。对于以Python为主、侧重数据分析的团队,应重点考察工具在Pandas链式调用、缺失值策略推断及matplotlib可视化代码生成上的逻辑完备性;而对于嵌入式或实时系统开发,则需验证其在C语言指针运算、内存对齐约束及中断服务程序生成中的安全符合度。
以下为经实测验证的提效策略:
- 在指令中显式声明约束条件,例如『不使用第三方包』『兼容Python 3.8+』『避免全局变量』,可使准确率提升22%至35%;
- 对关键业务逻辑,采用『生成→人工审查→反向提问验证』三步法:向工具提问『上述代码在用户传入None时会如何表现?』,观察其自我纠错能力;
- 建立团队级提示词模板库,将高频场景(如JWT鉴权中间件、SQL注入防护模板)固化为可复用指令,降低语义漂移风险;
- 定期用内部遗留系统的真实报错日志测试工具的诊断能力,重点关注其是否混淆根本原因与表象症状。
企业采购决策中,除准确率外,必须同步评估私有化部署能力、代码片段审计日志完整性及与现有CI/CD流水线的集成深度。某些工具虽在公有云API测试中表现优异,但其私有化版本因算力限制导致上下文窗口压缩,逻辑完备性下降逾40%。此外,若工具无法导出完整的提示词与响应审计记录,则难以满足金融、医疗等强监管行业的合规追溯要求。
| 工具名称 | 语法正确率 | 逻辑完备率 | 首次命中率 | 安全合规率 | 中文指令理解 |
|---|---|---|---|---|---|
| 工具A | 98.2% | 86.5% | 73.1% | 68.9% | 94.7% |
| 工具B | 96.7% | 89.3% | 78.4% | 82.1% | 91.2% |
| 工具C | 95.1% | 81.6% | 65.8% | 75.3% | 93.5% |
| 工具D | 97.4% | 84.2% | 70.2% | 71.6% | 89.8% |
综上所述,AI编程助手的准确率并非静态标量,而是动态依赖于指令颗粒度、领域知识密度及工程约束强度的复合函数。当前技术已能稳定支撑原型验证与样板代码生成,但在承载核心业务逻辑、满足严苛SLA要求的生产环境中,仍需开发者保持审慎的技术主权意识。最高效的协作模式,不是让AI替代思考,而是将其转化为延伸人类工程判断力的精密透镜——当工具准确率触及瓶颈时,真正决定开发质量的,永远是人对问题本质的洞察、对权衡取舍的勇气,以及对代码背后世界的敬畏。未来进步的方向,不在于追求100%的机械准确,而在于构建人机之间更透明、可追溯、可干预的协同契约。