👁 42 次阅读
配图
一、这条流水线解决什么问题
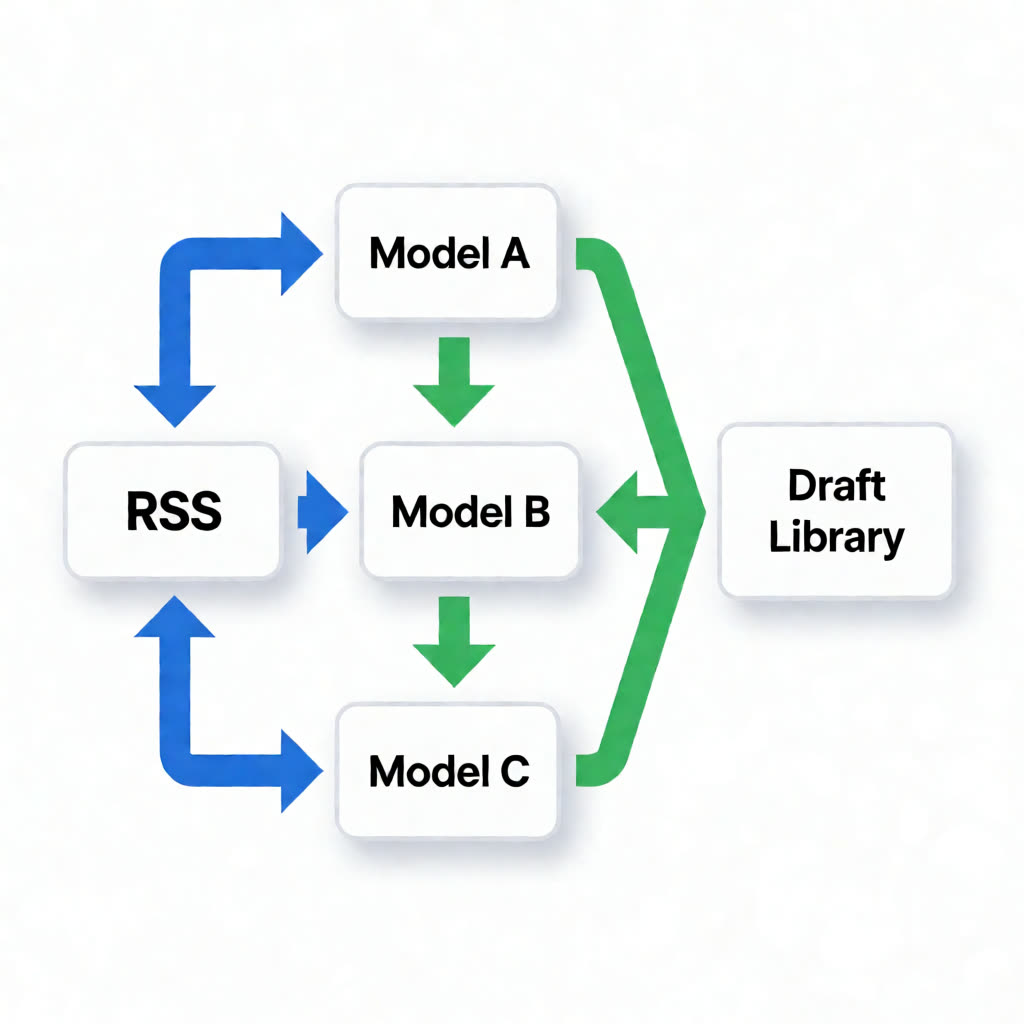
RSS 到草稿的多模型流水线,核心不是让模型直接发布,而是把采集、清洗、选题、初稿、审校和入库串成可回放流程。n8n 负责调度与状态,模型负责生成与判断,人工负责最终确认。建议把工作流拆成三层:采集层只负责抓取和标准化,生成层只接收干净输入,发布层只写草稿不触发上线。这样某一步失败时,能单独重跑,不会污染已完成的草稿。
配图
二、准备 n8n 与外部依赖
自托管或云版 n8n 都能完成。自托管时先用 Docker 起一个最小实例,再在 Credentials 中配置模型与 CMS 凭据。下面的命令只演示启动方式,密码、域名和时区按自己的环境替换。
docker run -d --name n8n -p 5678:5678 -e N8N_BASIC_AUTH_ACTIVE=true -e N8N_BASIC_AUTH_USER=editor -e N8N_BASIC_AUTH_PASSWORD=change-me -e GENERIC_TIMEZONE=Asia/Shanghai n8nio/n8n
需要准备的外部依赖包括:RSS 源列表、模型 API 凭据、正文抽取目标站点的可访问性、草稿库 API。模型侧至少准备一个轻量模型和一个长上下文模型;如果只用一个模型,也要在提示词与温度上区分生成和审校。草稿库可以是 WordPress、Notion、飞书多维表格或自建 CMS,原则是能写入草稿状态并保留来源链接。
三、多模型分工与节点映射
多模型不是越多越好,而是让不同阶段承担不同风险。下面这张表可以直接作为工作流设计清单。
| 阶段 | 模型角色 | 输入 | 输出 | 失败处理 |
|---|---|---|---|---|
| 摘要 | 轻量快速模型 | 标题、正文前段 | 三行摘要与关键词 | 重试一次后转模板摘要 |
| 提纲 | 长上下文模型 | 摘要、正文、站点定位 | 章节提纲与要点 | 标记待人工补提纲 |
| 初稿 | 长上下文模型 | 提纲、原文摘录、风格要求 | 完整草稿 | 降级为提纲扩写 |
| 事实校核 | 推理或检索增强模型 | 草稿、原文、来源链接 | 风险清单与待核句 | 保留原稿并转人工 |
| 编辑润色 | 通用模型 | 草稿、风险清单 | 可审阅终稿 | 保留润色前版本 |
把每个模型调用封装成独立节点,输出统一写入 model_stage、model_output、prompt_version 三个字段。这样后面排查问题时,能知道是哪一阶段、哪一版提示词出的问题。
四、RSS 采集:先建立候选池
用 RSS Read 节点读取源列表。源列表不要写死在节点里,建议放在 Set 节点或外部表格中,再由 Split In Batches 逐个读取。每个 RSS 项至少保留 title、link、guid、pubDate、content 和 source_name。随后用 Merge 节点汇总多个源,用 Remove Duplicates 节点按 link 去重。
采集层要加两道过滤:第一道按标题关键词排除明显无关内容;第二道按正文长度和链接可访问性过滤。不要在这一层调用大模型,否则会浪费额度。可以用 IF 节点判断标题是否包含目标关键词,也可以在 Set 节点生成 candidate_status 字段,值为 new、filtered 或 duplicate。
五、正文抽取与标准化
RSS 里的正文经常不完整,需要 HTTP Request 节点访问原文链接。请求配置建议:方法 GET,跟随重定向,设置超时,响应格式选文本。拿到 HTML 后用 HTML Extract 节点抽取 article、main 或站点正文容器。抽取失败时不要中断,回退到 RSS 的 content 字段,并在 extract_status 中标记 fallback。
标准化字段建议包括:source_id、title、url、published_at、content_text、word_count、language、status。正文过长时按模型上下文预算切片,保留标题、导语、关键段落和结尾,不要简单截断中间。可以用表达式控制长度:
{{ $json.content_text.slice(0, 12000) }}
这个数字只是示例,实际按模型上下文和成本调整。切片后仍要保留原文链接,方便校核阶段回溯。
六、去重、选题与优先级
去重至少做三层:URL 规范化去重、标题相似去重、正文指纹去重。URL 去重要去掉追踪参数;标题相似可以用 Remove Duplicates 节点的相似比较;正文指纹可以取前若干字符的哈希。三层都通过后再进入选题。
选题过滤建议用规则加模型评分:规则层排除广告、招聘、活动报名等低价值内容;模型层只做选择题,输出 priority 为高、中、低,并给出理由。优先级为低的内容不进入生成,只保留在候选池。这样能控制成本,也能让编辑知道流水线为什么跳过某篇文章。
七、用 HTTP Request 统一封装模型调用
不同模型服务商的字段名不完全一致,但 n8n 的 HTTP Request 节点可以统一封装。建议把 system prompt 和 user prompt 放到上游 Set 节点,HTTP Request 只负责发送。Body 可以用表达式构造,下面是一个通用结构,字段名按服务商文档调整:
{{ { model: $json.model, messages: [{ role: 'system', content: $json.system_prompt }, { role: 'user', content: $json.user_prompt }] } }}
调用时统一记录 model、prompt_version、input_tokens、output_tokens、latency 和 status。如果服务商返回结构不同,在 HTTP Request 后面加 Set 节点做归一化,不要让下游节点直接依赖原始响应。
八、提示词与结构化输出
提示词要短而硬,明确角色、输入、输出格式和禁止事项。下面是一个摘要与提纲的模板,可以复制到 Set 节点:
角色:内容编辑。任务:根据 RSS 标题与正文,输出三段,分别以【摘要】【提纲】【风险】开头。要求:只使用输入中出现的信息;不确定处写待核;不要补充背景;不要写营销口号。输入标题:{{ $json.title }} 输入正文:{{ $json.content_text }}
初稿阶段再增加站点定位、目标读者、语气和长度要求。校核阶段把草稿与原文同时传入,要求模型逐条列出可能失真的句子、缺少来源的判断和需要人工确认的专有名词。不要让同一个模型在同一个提示里既写稿又自评,最好拆成两个节点,避免自评过度宽松。
九、质量门禁:什么草稿可以进入人工队列
质量门禁用 IF 节点实现,至少检查六项:标题是否为空、摘要是否包含来源、正文是否达到最小长度、来源链接是否可访问、风险清单是否为空、是否命中重复。任何一项失败,把 status 设为 review 并记录失败原因;全部通过才设为 draft。
建议再加一道轻量模型检查:让模型只回答草稿是否包含原文没有的事实、是否出现绝对化承诺、是否遗漏关键限定条件。输出用短标签,不要长篇解释。这样编辑打开草稿时,先看到风险清单,再决定是否采用。
十、写入草稿库与保留版本
写入草稿库时只创建草稿,不触发发布。WordPress 可以用 Post 节点设置状态为 draft;其他 CMS 用 HTTP Request 调用创建草稿接口。字段映射建议如下:标题取 title,正文取 final_content,摘要取 summary,标签取 keywords,来源链接放自定义字段,模型与提示词版本放备注字段。
每次生成保留三个版本:模型原始输出、校核后草稿、人工修改后的终稿。不要把原始输出覆盖掉,否则后续无法评估提示词效果。草稿库中增加 pipeline_run_id,与 n8n 执行记录对应,排查时能一键回放。
十一、错误处理、重试与降级
模型调用最常见的失败是超时、限流和返回格式异常。HTTP Request 节点开启重试,但只对超时和限流重试;鉴权失败、参数错误不要重试。等待节点做指数退避,重试次数按队列容量设置。仍然失败时走降级:摘要用规则截取,提纲用固定模板,初稿保留原文摘录并标记 need_manual。
建议单独建一个 Error Trigger 工作流,把失败节点、错误信息、输入摘要和运行链接写入日志表,并通知负责人。错误日志不要记录完整密钥和用户隐私字段。对于批量 RSS,失败项进入重试队列,不要阻塞整条流水线。
十二、可观测性与日常维护
可观测性至少覆盖四类指标:采集成功率、正文抽取回退率、模型失败率、人工采纳率。人工采纳率最重要,它反映流水线是否真正减轻编辑负担。每次修改提示词都要更新 prompt_version,先在小流量源上试跑,再逐步扩大。
维护时定期清理无效 RSS 源、更新站点正文选择器、检查模型服务商字段变更、复核高风险领域的校核规则。把常用排查动作写成检查清单:RSS 是否有新项、HTTP 是否被反爬、HTML Extract 是否命中空节点、模型返回是否被归一化、CMS 草稿状态是否正确。
十三、常见问题排查
- RSS 节点没有数据:先检查源地址是否可访问,再看 n8n 执行记录里 HTTP 状态码和返回体。
- 正文抽取为空:换 CSS 选择器,或回退到 RSS content,并记录 fallback 原因。
- 模型返回空内容:检查 Body 字段名、鉴权头、模型名称和上下文长度。
- 重复草稿反复出现:把 URL 规范化、标题相似和正文指纹三层去重都打开。
- 草稿库写入失败:确认 API 权限、字段名、状态值,以及正文是否超过接口限制。
- 人工修改量很大:回看提示词是否缺少站点定位、目标读者和禁用表达。
十四、可执行建议
先不要追求全自动。第一天只搭采集、清洗和去重三段,确认候选池干净;第二天接入摘要和提纲,观察输出稳定性;第三天再加初稿、校核和草稿库写入。每个模型节点都保留原始输入输出,先用少量源试跑,再扩大范围。上线前用一个固定检查表验收:来源可追溯、风险可定位、草稿可回放、失败可重试、人工可接管。满足这五点,再考虑增加更多模型或更多发布渠道。