👁 76 次阅读
在大模型落地实践的浪潮中,检索增强生成(RAG)已从技术概念演进为工业级应用标配。它通过将私有知识库与大语言模型动态结合,在保障事实准确性的同时显著降低幻觉风险,成为企业构建智能问答、知识助手、合规文档系统的核心范式。然而,RAG并非开箱即用的黑盒——其底层涉及文档解析、分块策略、嵌入模型适配、向量索引构建、查询重写、结果精排与响应合成等多个耦合环节,任意一环的失配都可能导致响应延迟高、召回率低或上下文冗余。因此,选择一个契合业务规模、团队能力与长期演进路径的RAG框架,远比盲目追逐热门工具更为关键。
当前开源生态中已涌现出多套成熟度各异的RAG开发框架,它们在抽象层级、模块粒度、扩展机制与社区支持上呈现显著分化。有的以极简API降低入门门槛,适合MVP快速验证;有的则提供细粒度控制能力,支撑千万级文档的低延迟检索与复杂推理链编排。这种多样性既是繁荣的体现,也带来了选型困惑:当项目需要对接内部OA系统中的非结构化PDF报告,同时要求支持中文语义检索与权限分级过滤时,LangChain是否仍是最优解?当团队缺乏专职向量数据库运维能力,又希望避免自建集群的运维负担,LlamaIndex与托管型向量服务的协同模式是否更可持续?本文不预设立场,仅基于公开文档、典型用例及社区实践反馈,对四类主流RAG框架进行客观、结构化的横向剖析。
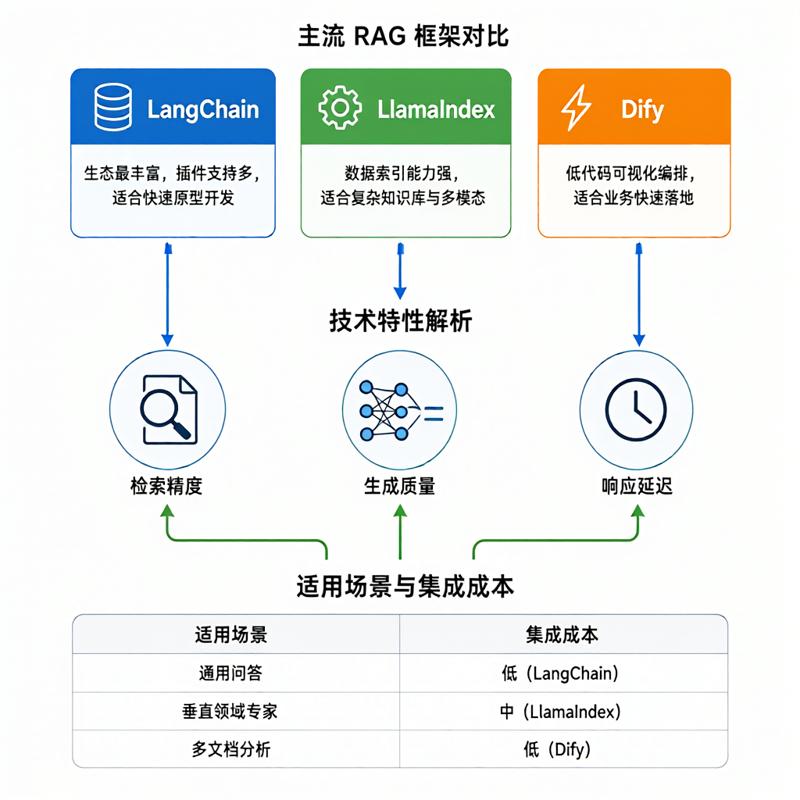
核心设计理念与抽象层级对比
LangChain 是最早形成完整生态的RAG框架之一,其设计哲学强调『链式编排』与『工具即插件』。它将整个RAG流程拆解为可组合的组件:DocumentLoader负责数据接入,TextSplitter控制分块逻辑,Embeddings封装各类嵌入模型调用,VectorStore抽象向量存储接口,Retriever统一检索入口,Chain协调检索与生成逻辑。这种高度解耦的设计赋予了极强的灵活性,开发者可自由替换OpenAIEmbeddings为本地部署的BGE-M3,或将Chroma替换为Weaviate以启用属性过滤。但代价是学习曲线陡峭——初学者需理解10余个核心类之间的协作关系,且默认配置往往无法直接应对中文长文本的语义断裂问题。
LlamaIndex 则采取『数据为中心』的路径,将索引(Index)作为核心抽象单元。它默认假设用户拥有明确的知识源,并围绕『如何高效构建与查询索引』进行优化。其Index类天然支持多种结构:从最基础的向量索引,到融合关键词与向量的HybridIndex,再到支持图谱关系的KnowledgeGraphIndex。这种设计使LlamaIndex在处理技术文档、API手册等具有内在层级结构的数据时表现出色,例如可自动识别『函数名→参数说明→返回值示例』的嵌套关系并构建跨段落引用。不过,其对非标准数据源(如加密邮件归档、扫描版合同图像OCR结果)的预处理支持相对薄弱,常需额外编写适配器代码。
Haystack 由deepset公司主导开发,定位为生产就绪型NLP框架。它采用清晰的Pipeline范式,将整个RAG流程定义为有向无环图(DAG),每个节点承担单一职责:FileConverter转换格式、PreProcessor清洗文本、Embedder计算向量、Retriever执行搜索、Reader精读答案。这种显式声明式编程风格极大提升了流程可调试性与可观测性,特别适合需要满足审计要求的金融、医疗等强监管场景。但Haystack对LLM生成环节的抽象较弱,早期版本甚至未内置ChatModel接口,需手动拼接Prompt模板,近期版本虽已增强,但整体生态活跃度不及LangChain与LlamaIndex。
FastRAG 是国内团队推出的轻量级框架,聚焦于中文场景下的工程效率。它默认集成中文分词器(如Jieba)、适配中文嵌入模型(如bge-zh)、预置常见文档解析器(支持WPS、OFD等国产格式),并内置面向政务、法律领域的检索优化策略,例如对『法条第X条第Y款』的结构化识别与引用溯源。其API设计极度简洁,三行代码即可完成从PDF加载到问答响应的全流程。然而,这种垂直优化也带来通用性折损——当需要接入英文专利库或处理代码仓库级别的多语言混合内容时,扩展成本明显升高。
向量数据库兼容性与扩展能力
RAG系统的性能瓶颈往往不在大模型本身,而在于向量检索的吞吐量与精度。各框架对向量数据库的支持策略差异显著。LangChain 提供最广泛的官方适配器,覆盖Chroma、FAISS、Pinecone、Qdrant、Weaviate、Milvus等十余种引擎,且多数适配器由社区持续维护,更新及时。但这种广度也导致质量参差——部分适配器仅实现基础add/query接口,缺失元数据过滤、近似最近邻(ANN)参数调优等高级功能,实际使用中需二次开发。
LlamaIndex 的向量存储层采用『原生优先』策略,对Qdrant、Weaviate、Elasticsearch等支持深度集成,例如可直接利用Weaviate的GraphQL查询语法进行复杂条件过滤,或调用Elasticsearch的BM25+向量混合打分。但对于Chroma这类轻量级嵌入式数据库,仅提供基础CRUD能力,难以启用其内存映射优化或持久化快照功能。值得注意的是,LlamaIndex 4.x起引入了StorageContext机制,允许开发者在不修改索引逻辑的前提下,将向量、文档元数据、图谱关系分别存入不同后端,为混合存储架构提供了原生支持。
Haystack 对数据库的绑定较为审慎,官方主推Elasticsearch与OpenSearch,因其成熟的全文检索能力可与向量检索形成互补。对于纯向量引擎如Milvus,Haystack提供Community版本适配器,但稳定性与功能完整性需自行验证。其Pipeline设计天然支持多检索器并行调用——例如同时发起向量检索与关键词检索,再通过EnsembleRetriever融合结果,这种架构在模糊查询与术语歧义场景下优势突出,但对数据库本身的并发连接管理提出更高要求。
FastRAG 在向量库选型上采取务实路线,优先保障Chroma与Qdrant的开箱体验,二者均经过中文长文本检索压力测试。其特色在于内置『向量库健康看板』,可实时监控索引碎片率、查询P95延迟、内存占用等指标,并提供一键优化建议。不过,该框架暂未开放自定义向量库驱动的注册接口,若需对接企业已有的Tair或Redis Stack向量模块,则必须修改核心代码,扩展成本高于其他框架。
中文支持深度与本地化适配
中文RAG面临独特挑战:字词边界模糊导致分块不合理、专业术语嵌套影响语义嵌入、长段落缺乏自然停顿点造成上下文截断。LangChain 默认TextSplitter针对英文标点优化,直接用于中文PDF易产生『的』『了』等虚词孤立成块,需手动配置ChineseRecursiveTextSplitter或集成jieba分词。其Embeddings模块虽支持加载HuggingFace中文模型,但模型权重下载、CUDA显存分配、batch size调优等细节需开发者自行把控,缺乏中文场景的默认最佳实践。
LlamaIndex 近期版本强化了中文友好性,内置ChineseTextSplitter支持按句号、问号、感叹号及中文括号进行智能切分,并自动合并过短句子。其文档加载器(如PDFReader)可调用PyMuPDF而非pdfplumber,显著提升扫描版PDF的OCR文本提取准确率。更关键的是,LlamaIndex社区贡献了大量中文嵌入模型微调脚本,涵盖法律文书、医学文献、政务公文等垂直领域,开发者可基于自有语料快速蒸馏专用嵌入模型,这是LangChain生态目前尚未系统化提供的能力。
Haystack 的中文支持主要依赖其Reader组件。其FARMReader模型支持中文BERT变体,可在检索结果基础上进行指针式答案抽取,对『根据《XX条例》第X条,应……』这类结构化答案定位准确率较高。但Haystack的DocumentStore层对中文元数据字段(如『发文机关』『文号』)的索引优化不足,若需按发文年份范围+关键词组合检索,常需在应用层做二次过滤,影响端到端性能。
FastRAG 将中文适配下沉至基础设施层。其文档解析模块内置国密SM4解密支持,可直接读取政府专网加密PDF;分块策略融合了《GB/T 18354-2021 物流术语》等行业标准,对『物流园区』『多式联运』等复合词保持完整;嵌入模型默认启用BGE-M3的中文子模型,并预置了针对公文语体的后处理规则,例如自动忽略『特此通知』『请遵照执行』等固定结尾短语的向量贡献度。这些深度定制虽提升开箱体验,但也意味着技术栈锁定风险增加。
生产部署成熟度与运维成本
从原型到生产,框架的可观测性、弹性伸缩与故障恢复能力至关重要。LangChain 提供基础的CallbackHandler机制,可记录每一步耗时与输入输出,但缺乏统一日志格式与分布式追踪支持。其部署通常依赖Flask/FastAPI封装,需自行实现请求队列、缓存失效、降级熔断等逻辑。社区虽有LangServe项目简化API暴露,但对异步流式响应、多租户隔离等企业级需求覆盖有限。
LlamaIndex 原生支持AsyncEngine,所有检索与生成操作均可异步执行,配合FastAPI可轻松实现SSE流式推送。其Index对象支持序列化为JSON或二进制格式,便于离线训练后热加载,减少服务启动延迟。不过,其分布式索引构建(如跨节点分片)仍处于实验阶段,大规模知识库扩容需依赖外部编排工具。
Haystack 的Production模式经过银行、制药企业真实场景锤炼,内置Prometheus指标导出、Jaeger分布式追踪、Kubernetes原生部署清单(Helm Chart),并提供详细的SLO监控看板模板。其DocumentStore支持读写分离与自动故障转移,当主Elasticsearch节点宕机时,可无缝切换至副本集群继续服务,这是其在高可用场景中不可替代的优势。
FastRAG 针对国内云环境做了深度适配,支持阿里云OSS、腾讯云COS作为文档存储后端,并内置与阿里云百炼、华为云盘古大模型的直连SDK,避免API网关多次转发带来的延迟叠加。其运维界面提供中文错误码体系与根因分析提示,例如当出现『检索召回率低于阈值』时,会自动建议检查分块大小或嵌入模型版本,大幅降低一线运维人员的技术门槛。
| 框架 | 中文分块支持 | 主流向量库适配数 | 生产级可观测性 | 典型学习周期 |
|---|---|---|---|---|
| LangChain | 需手动配置或引入第三方模块 | 12+ | 基础日志,需集成外部工具 | 2–4周 |
| LlamaIndex | 内置ChineseTextSplitter | 8 | 异步追踪、指标导出 | 1–3周 |
| Haystack | 依赖Reader组件,分块层较弱 | 5(含社区扩展) | 全链路SLO监控、K8s原生支持 | 3–6周 |
| FastRAG | 深度定制,支持行业标准分块 | 2(Chroma/Qdrant为主) | 中文错误诊断、云平台直连 | 3–5天 |
选择RAG框架不应追求『最强』,而应锚定『最合适』。若团队具备较强工程能力,且知识库类型多元、未来需频繁迭代检索策略,LangChain的开放生态与庞大社区是长期价值所在;若聚焦技术文档、研究论文等结构化知识,追求索引构建效率与查询精度,LlamaIndex的数据中心理念更具优势;若项目处于强监管行业,对审计日志、服务SLA、灾备方案有刚性要求,Haystack的生产就绪基因难以被替代;若面向国内政务、国企客户,需快速交付、符合信创要求且运维资源有限,FastRAG的垂直优化能显著缩短上线周期。最终决策还需结合具体的知识规模、更新频率、安全合规等级及团队技能图谱综合权衡。值得强调的是,所有框架均在快速演进,今日的短板可能在下一版本中补齐,因此建立清晰的评估维度与持续跟踪机制,比一次性锁定某个框架更为重要。